Gdy komórek pamięci nie dało się już sensownie zmniejszać, producenci zaczęli układać je w pionie, warstwa na warstwie. Dziś to podstawowy nośnik w wielu systemach, od telefonów po centra danych. Ta technologia rozwiązała część dawnych problemów, ale przyniosła nowe, opisane w badaniu z 2024 roku.
Od płaskiej pamięci do wieżowca
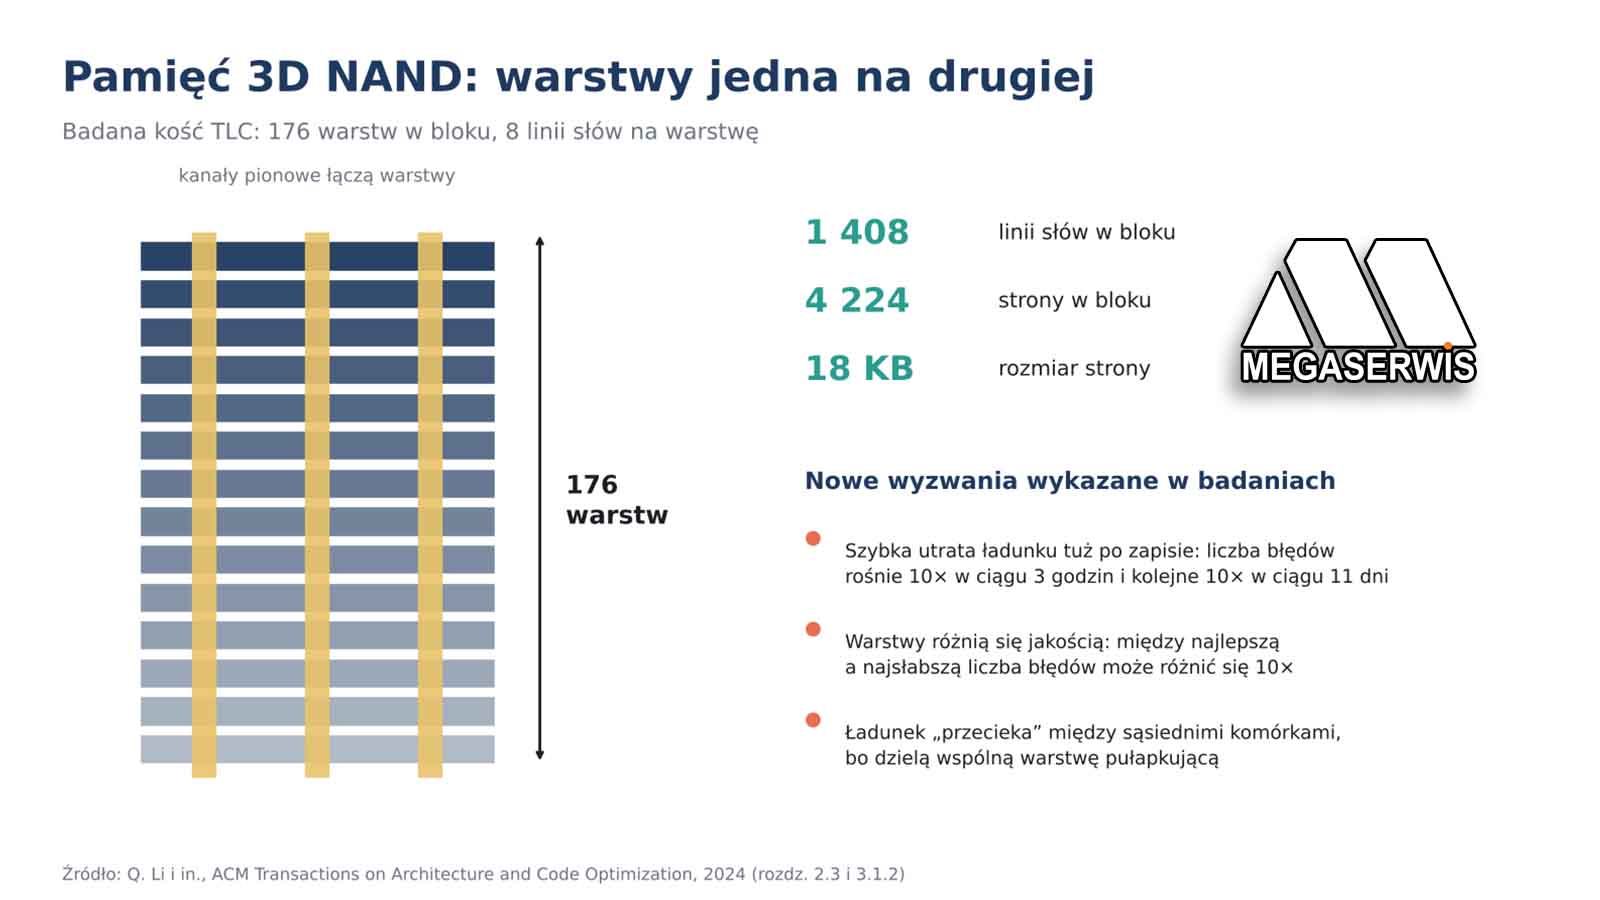
W klasycznej pamięci płaskiej (2D) komórki leżą obok siebie na powierzchni krzemu. W pamięci 3D NAND ułożono wiele takich warstw jedna na drugiej i połączono je pionowymi kanałami wytrawionymi w strukturze. Zmieniła się też budowa samej komórki:
|
Cecha |
Pamięć płaska (2D) |
Pamięć 3D NAND |
|---|---|---|
|
Sposób przechowywania ładunku |
bramka pływająca (przewodnik) |
zwykle pułapka ładunku (izolator) o budowie cylindrycznej |
|
Rozmiar elementów (stan z 2017 r.) |
15–19 nm |
50–54 nm przy 48–64 warstwach |
|
Wytrzymałość (stan z 2017 r.) |
punkt odniesienia |
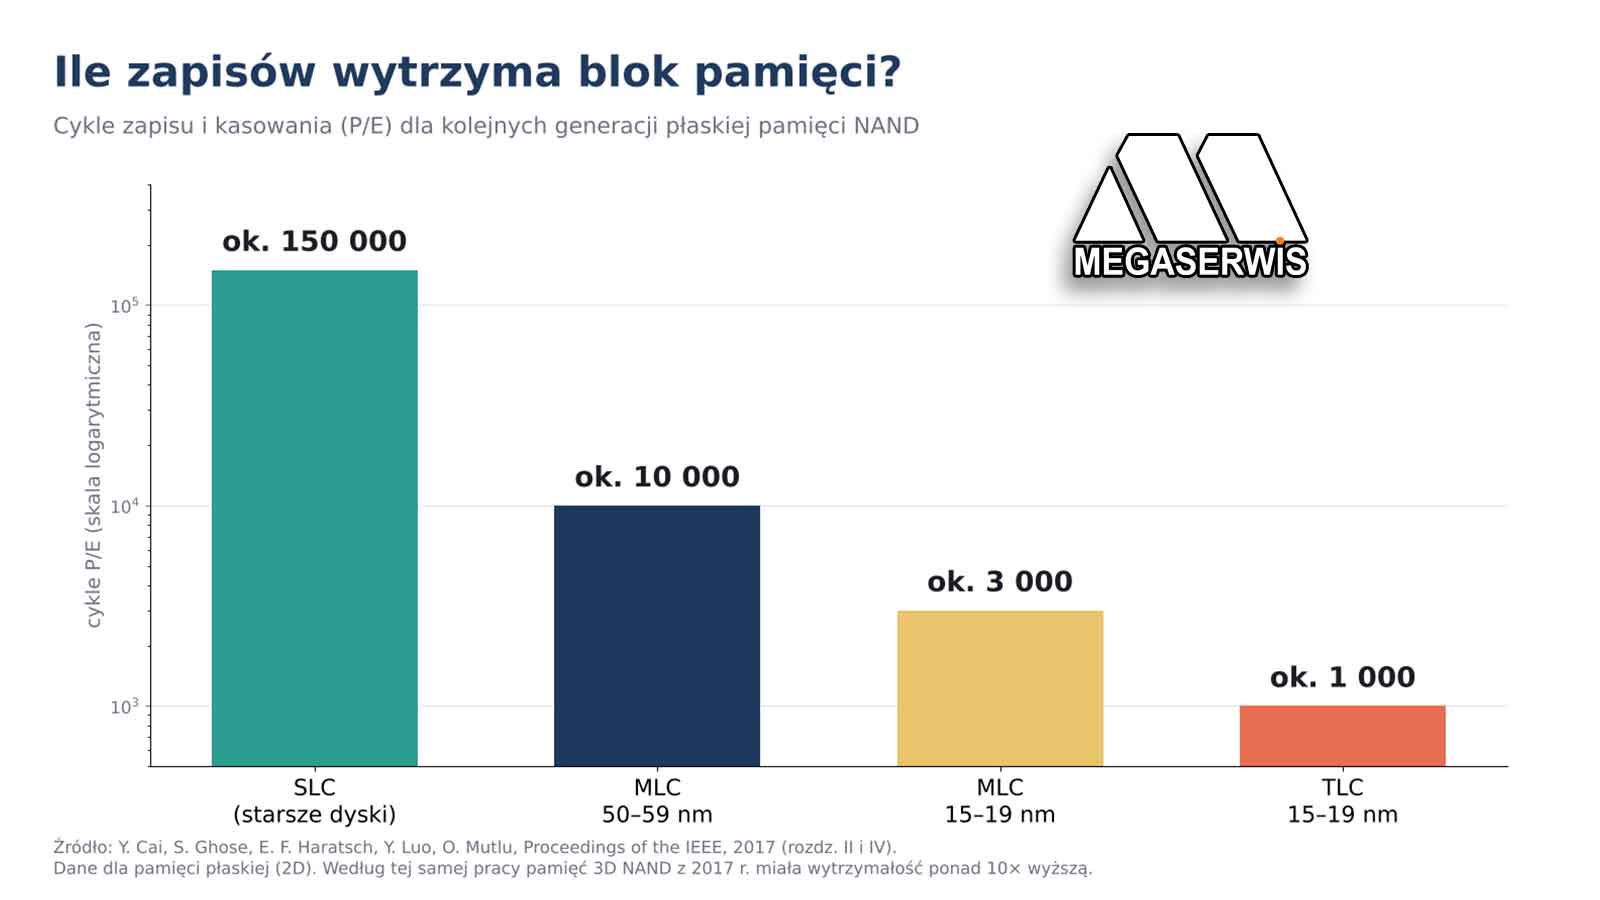
ponad 10× wyższa |
Większe komórki w pierwszych generacjach 3D NAND oznaczały mniej zakłóceń między sąsiadami i przy odczycie. Producenci mogli nawet wrócić do prostszego, jednoetapowego zapisu. Już w 2017 roku badacze ostrzegali jednak, że utrata ładunku w czasie (retencja) będzie w 3D NAND większym problemem. Ładunek może bowiem uciekać także w pionie, między warstwami. Przewidywali też, że gdy komórki 3D znów się zmniejszą, wrócą wszystkie problemy znane z pamięci płaskiej.
Jak wyglądała badana pamięć
Zespół Q. Li i współpracowników (2024) badał prawdziwe kości 3D TLC:
- 176 warstw w bloku, po 8 rzędów komórek (linii słów) na warstwę, czyli 1408 rzędów;
- 3 strony na rząd, czyli 4224 strony w bloku, po 18 KB każda;
- testy obejmowały zużycie od 0 do 7000 cykli zapisu i kasowania, wygrzewanie w 120°C (symulacja wieloletniego przechowywania) oraz do 21 tys. odczytów.
Trzy nowe problemy pamięci 3D
Autorzy, powołując się na wcześniejsze badania, wskazują trzy zjawiska nieznane z pamięci płaskiej:
- Szybka utrata ładunku tuż po zapisie. Warstwa izolatora jest cieńsza, żeby przyspieszyć zapis, a komórki w jednym rzędzie dzielą wspólną warstwę pułapkującą. Już po 2 godzinach zaczyna się wyciek ładunku. Liczba błędnych bitów rośnie dziesięciokrotnie w ciągu 3 godzin i kolejne dziesięć razy w ciągu 11 dni.
- Różnice między warstwami. Pionowych kanałów nie da się wytrawić idealnie równo na całej wysokości. W efekcie warstwy tego samego bloku zachowują się różnie. Między najlepszą a najsłabszą warstwą liczba błędów może się różnić dziesięciokrotnie.
- Przeciekanie ładunku między sąsiadami. Gdy dwie sąsiednie komórki mają różne napięcie, ładunek przepływa z „wyższej” do „niższej” przez wspólną warstwę.
Co wykazały pomiary
Badacze porównali dwa sposoby przygotowania kontrolera do odczytu. Pierwszy to uproszczony model, w którym każdy stan opisuje gładka krzywa. Tak działają dzisiejsze dyski: parametry są ustalane z góry na podstawie modelu. Drugi to rzeczywisty rozkład napięć zmierzony wieloma odczytami. Daje on najlepsze wyniki, ale w normalnej pracy dysku jest niepraktyczny ze względu na koszt.
Cztery główne wnioski:
- Zwykle wystarcza szybki odczyt. Dodatkowe odczyty są potrzebne głównie przy bardzo silnych zakłóceniach. Błędy od długiego przechowywania skupiają się między dwoma najwyższymi stanami, a błędy od wielokrotnego odczytu między dwoma najniższymi.
- Model nie nadąża za rzeczywistością. Przy silnych zakłóceniach odczyt oparty na modelu potrzebował o 46,9% (3000 cykli), 45,4% (5000) i 13,9% (7000) więcej poziomów odczytu niż odczyt oparty na rzeczywistym rozkładzie. Stron, których nie dało się odczytać, było w nim więcej odpowiednio o 76,3%, 63,7% i 7,1%.
- Warstwy wymagają różnego traktowania. Rzędy z pierwszej połowy bloku potrzebowały średnio około połowy tylu poziomów odczytu co rzędy z drugiej połowy.
- „Optymalne” napięcie z modelu nie zawsze jest najlepsze. Lepsze wyniki dawało napięcie lekko przesunięte względem wyliczonego.
Na tej podstawie autorzy zaproponowali metodę ΔRV. Dla każdego rzędu komórek koryguje ona napięcie odczytu o z góry wyliczoną poprawkę. Wyniki dla 3000, 5000 i 7000 cykli przy silnych zakłóceniach:
|
Cykle zapisu i kasowania |
Mniej poziomów odczytu |
Mniej stron nie do odczytania |
Krótszy średni czas odpowiedzi |
|---|---|---|---|
|
3000 |
18,92% |
28,13% |
6,73% |
|
5000 |
11,93% |
17,14% |
4,64% |
|
7000 |
0,67% |
1,55% |
1,89% |
Przy 7000 cykli różnice prawie znikają. Błędów było już więcej, niż kod korekcyjny LDPC potrafi poprawić, więc żadna z porównywanych metod nie radziła sobie z tymi stronami.
Co to oznacza w praktyce
Pamięć 3D NAND to nie po prostu „lepsza wersja” starej pamięci. Inaczej się zużywa i inaczej traci dane. Szczególnie wrażliwa jest na utratę ładunku, także w pierwszych godzinach po zapisie. Do tego poszczególne warstwy jednej kości zachowują się różnie. Skuteczny odczyt mocno zużytej pamięci wymaga więc dokładnej wiedzy o tym, jak w konkretnym miejscu przesunęły się napięcia, a nie tylko o tym, jak powinny wyglądać w teorii.
Źródła: Q. Li i in., „Characterizing and Optimizing LDPC Performance on 3D NAND Flash Memories”, ACM TACO, t. 21, nr 3, 2024 (rozdz. 2.1, 2.3, 3, 4.3); Y. Cai i in., Proceedings of the IEEE, 2017 (rozdz. VII).
Artykuł 6. Gdy dysk SSD przestaje odczytywać dane. Co mówią badania o odzyskiwaniu
Lead: Komunikat o błędzie odczytu oznacza, że dysk wyczerpał wszystkie wbudowane sposoby ratowania danych. Badania naukowe pokazują, że nawet wtedy część informacji wciąż tkwi w komórkach pamięci. Pokazują też jasno, gdzie kończą się możliwości.
Co się dzieje, gdy dysk zgłasza błąd
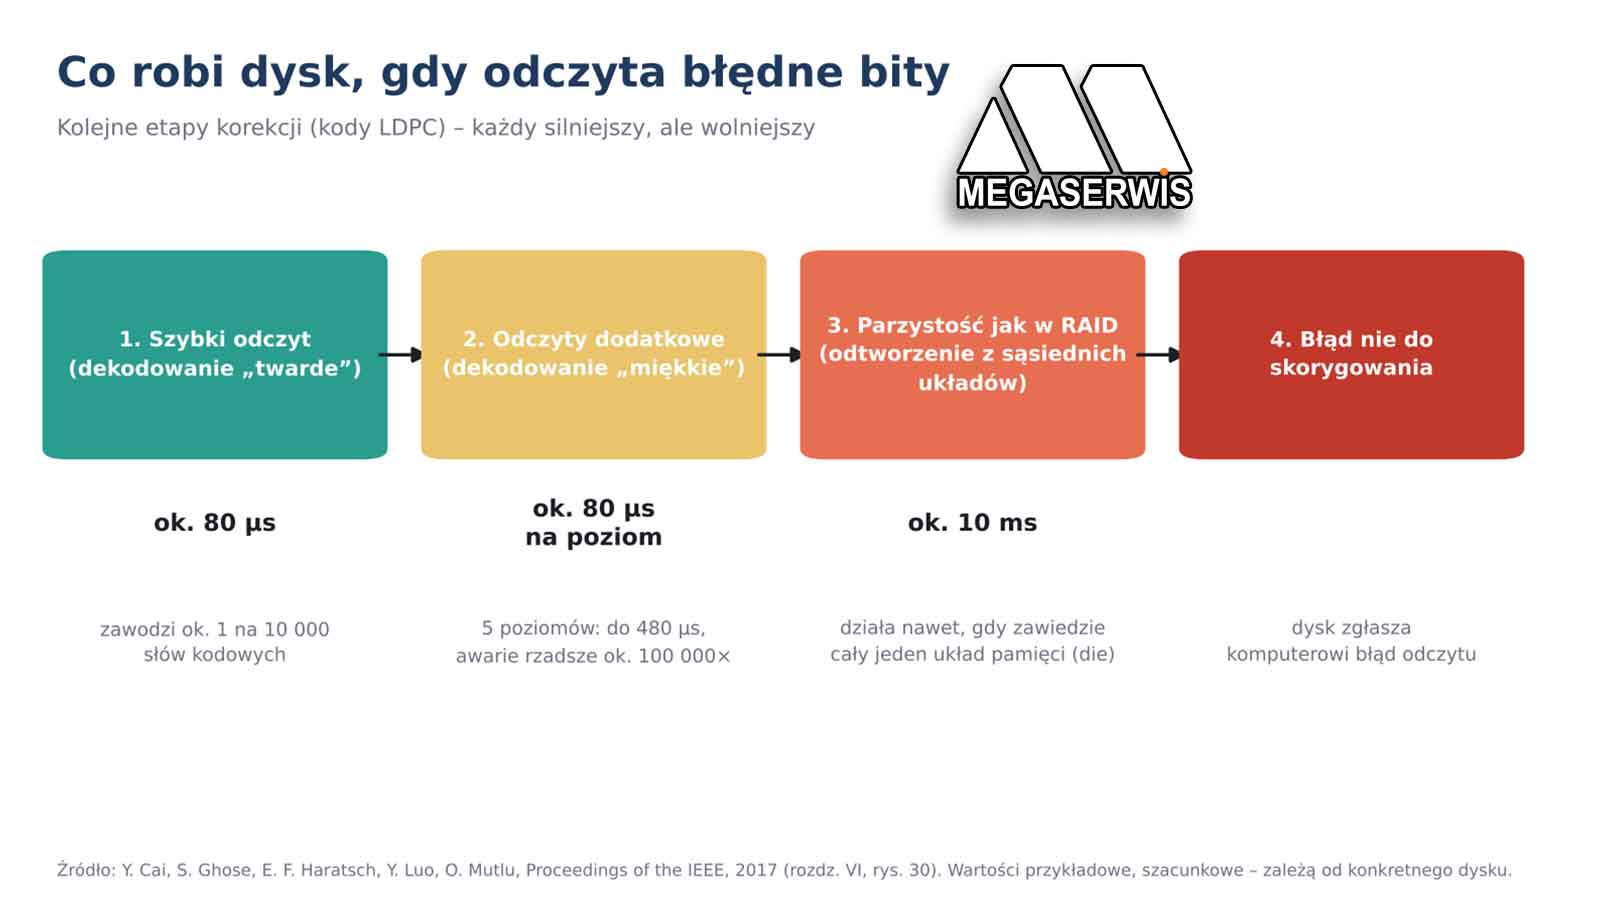
W artykule 4 opisaliśmy, jak kontroler próbuje odczytać dane. Najpierw szybki odczyt, potem odczyty dodatkowe przy innych napięciach, na końcu odtworzenie z parzystości. Dopiero gdy wszystko zawiedzie, dysk zgłasza błąd nie do skorygowania. Według publikacji w tym momencie może dochodzić do utraty danych, a sam dysk uznaje się za taki, który osiągnął kres żywotności.
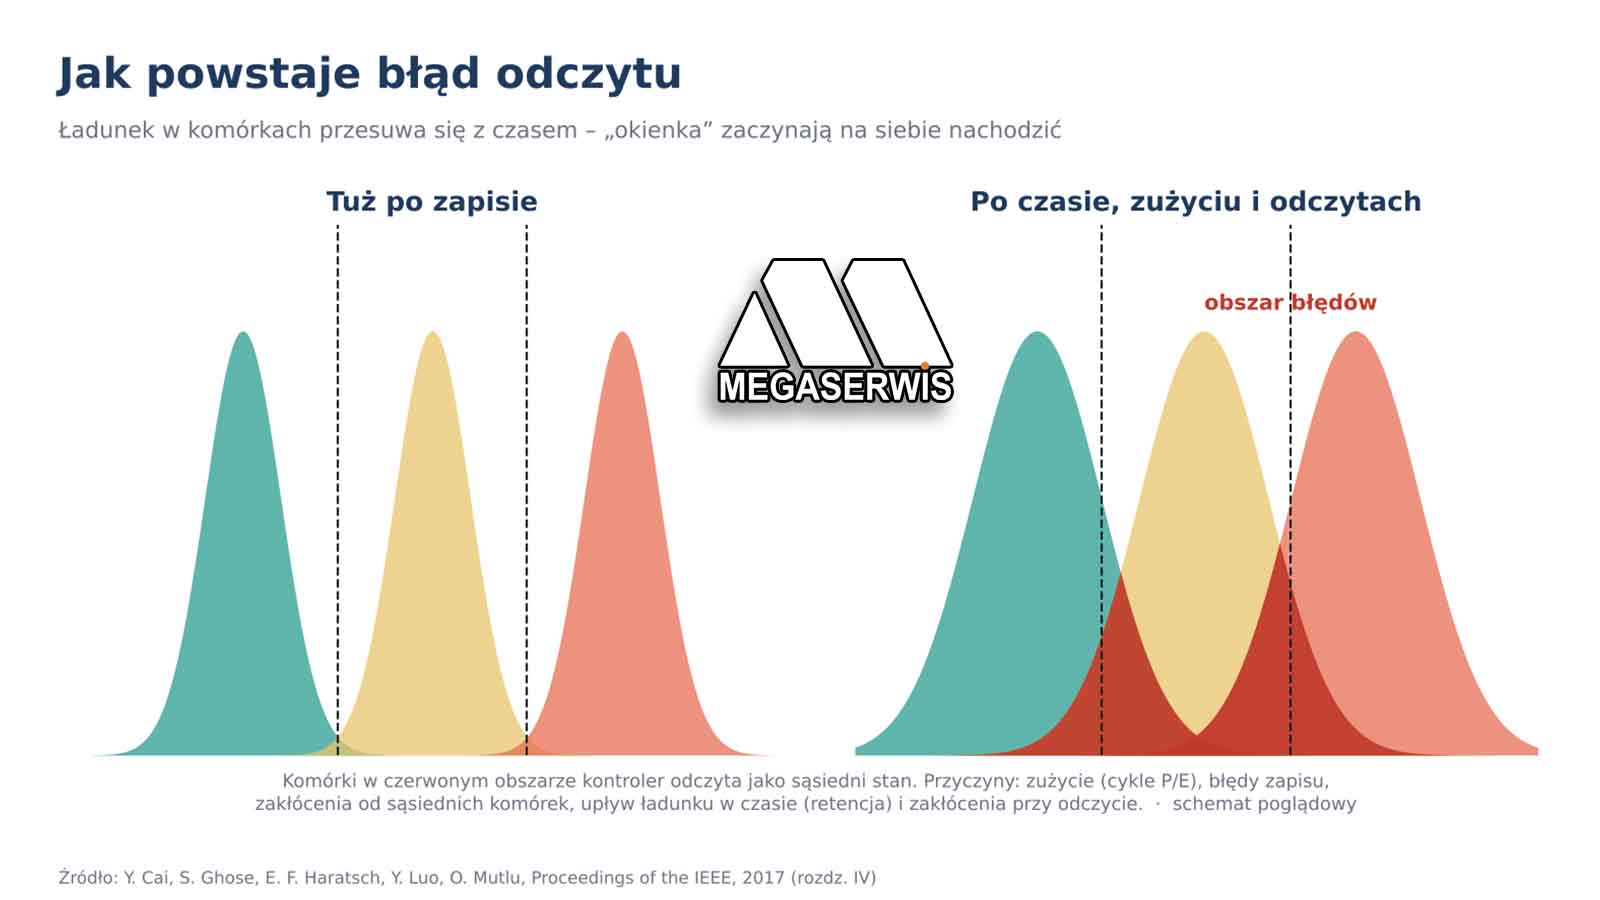
„Błąd nie do skorygowania” oznacza jednak tylko tyle, że błędnych bitów jest więcej, niż kod korekcyjny potrafi poprawić. Przy błędach opisanych w tej serii (zużycie, utrata ładunku, zakłócenia) komórki nadal przechowują ładunek, tylko jego poziom przesunął się tak, że standardowy odczyt daje zbyt wiele pomyłek. W takiej sytuacji pomaga wiedza o tym, jak i dlaczego komórki się przesunęły.
Komórki „przeciekające” i „odporne”
Badacze zauważyli, że z powodu nieuniknionych różnic produkcyjnych komórki różnią się podatnością na zakłócenia. Jedne tracą ładunek szybko, inne prawie wcale. Podobnie jest z wrażliwością na zakłócenia przy odczycie. Na tej obserwacji oparli dwie metody ratowania danych.
- Odzysk po utracie ładunku (RFR, Retention Failure Recovery). Komórki w spornym obszarze między dwoma stanami są klasyfikowane jako „szybko przeciekające” lub „odporne”. Komórka szybko przeciekająca znajdująca się w tym obszarze najpewniej spadła tam z wyższego stanu. Odporna najpewniej była tam od początku, czyli należy do niższego.
- Odzysk po zakłóceniach odczytu (RDR, Read Disturb Recovery). Działa analogicznie, ale dla komórek, których napięcie wzrosło od wielokrotnych odczytów sąsiednich danych.
Jak odróżnić te komórki? Metody najpierw zapisują aktualne napięcie każdej komórki, korzystając z mechanizmu ponownego odczytu przy różnych napięciach. Potem celowo wywołują dodatkową utratę ładunku lub dodatkowe zakłócenia i mierzą, o ile przesunęła się każda komórka. Na tej podstawie poprawiają część błędów bez udziału kodu korekcyjnego. Celem jest zmniejszenie liczby błędów na tyle, by resztę znów mógł poprawić standardowy mechanizm korekcji.
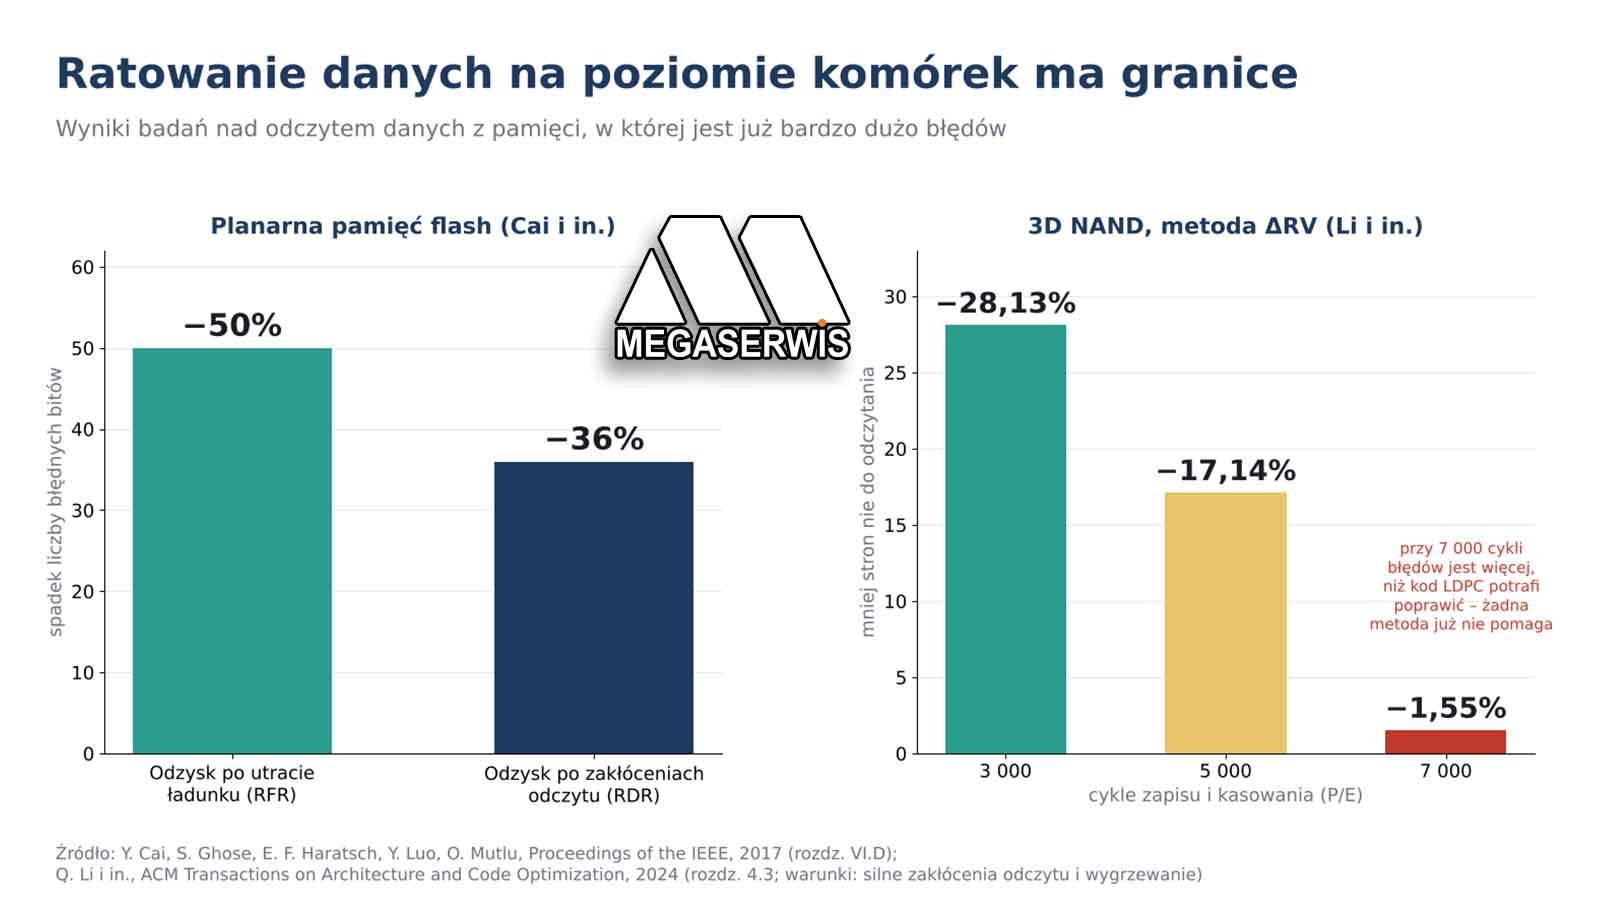
W badaniach RFR zmniejszała liczbę błędnych bitów na nieczytelnych stronach o 50%, a RDR o 36%.
Każdy rząd komórek jest inny
Badanie pamięci 3D NAND z 2024 roku (artykuł 5) dokłada kolejny element. Odczyt oparty na uproszczonym, uśrednionym modelu pamięci daje wyraźnie więcej stron nie do odczytania niż odczyt oparty na rzeczywistym rozkładzie napięć w danym miejscu. Przy 3000 cykli i silnych zakłóceniach było ich więcej o 76,3%.
Autorzy pokazali, że dopasowanie napięcia odczytu do konkretnego rzędu komórek odzyskuje część tej straty. Zarazem stwierdzili: gdy napięcie odczytu jest daleko od optymalnego, części danych może nie dać się odczytać wcale.
Granice możliwości
Te same badania pokazują też granice:
- Przy bardzo dużym zużyciu (7000 cykli w połączeniu z silnymi zakłóceniami) liczba błędów przekraczała możliwości kodu LDPC. Ulepszona metoda odczytu zmniejszała wtedy liczbę nieczytelnych stron już tylko o 1,55%. Nawet odczyt oparty na rzeczywistym rozkładzie nie mógł nadrobić ograniczonych możliwości korekcji.
- RFR i RDR zmniejszają liczbę błędów, ale ich nie eliminują. Działają, jeśli po ich zastosowaniu reszta błędów mieści się w możliwościach korekcji.
- Parzystość między układami pozwala przetrwać awarię jednego układu pamięci, ale nie wielu naraz.
Dlaczego odzyskiwanie danych z SSD to praca dla specjalistów
Zebrane w tej serii fakty wyjaśniają, dlaczego z dysku SSD nie da się po prostu „skopiować zawartości” jak z kartki:
- Dane w kościach są rozmieszczone według mapy kontrolera, przemieszane, a w dyskach samoszyfrujących także zaszyfrowane (artykuł 1).
- Zapisane wartości zależą od subtelnych poziomów ładunku. Te przesuwają się z czasem, z temperaturą, z zużyciem i przy odczytach (artykuły 2 i 3).
- Skuteczność odczytu zależy od precyzyjnego doboru napięć odczytu, w pamięci 3D nawet osobno dla różnych warstw (artykuły 4 i 5).
- Istnieją metody poprawiania błędów ponad możliwości wbudowanej korekcji, ale mają twarde granice (ten artykuł).
Co to oznacza w praktyce
Wnioski oparte bezpośrednio na badaniach:
- Rób kopie zapasowe. W dużych badaniach terenowych dyski SSD psuły się znacznie częściej, niż deklarowali producenci.
- Nie lekceważ temperatury. Wyższa temperatura przyspiesza utratę ładunku i wiąże się z wyższą awaryjnością.
- Pamiętaj, że zużycie jest nieuniknione. Im więcej zapisów przeszedł dysk, tym więcej błędów musi korygować. Przy skrajnym zużyciu nawet najlepsze metody odczytu przestają pomagać.
- Zwracaj uwagę na spowolnienie odczytu. Gdy błędów przybywa, kontroler częściej sięga po dodatkowe, wolniejsze odczyty, więc spowolnienie może towarzyszyć pogarszaniu się stanu pamięci (artykuł 4).