Każdy współczesny dysk prowadzi dziennik zdrowia zwany SMART. Potrafi ostrzec przed awarią na długo przed utratą danych, ale tylko wtedy, gdy wiemy, na które liczby patrzeć. Wyjaśniamy, jak czytać tabelę SMART, które atrybuty coś znaczą, a które straszą bez powodu.
Czym jest SMART i jak wygląda jego tabela
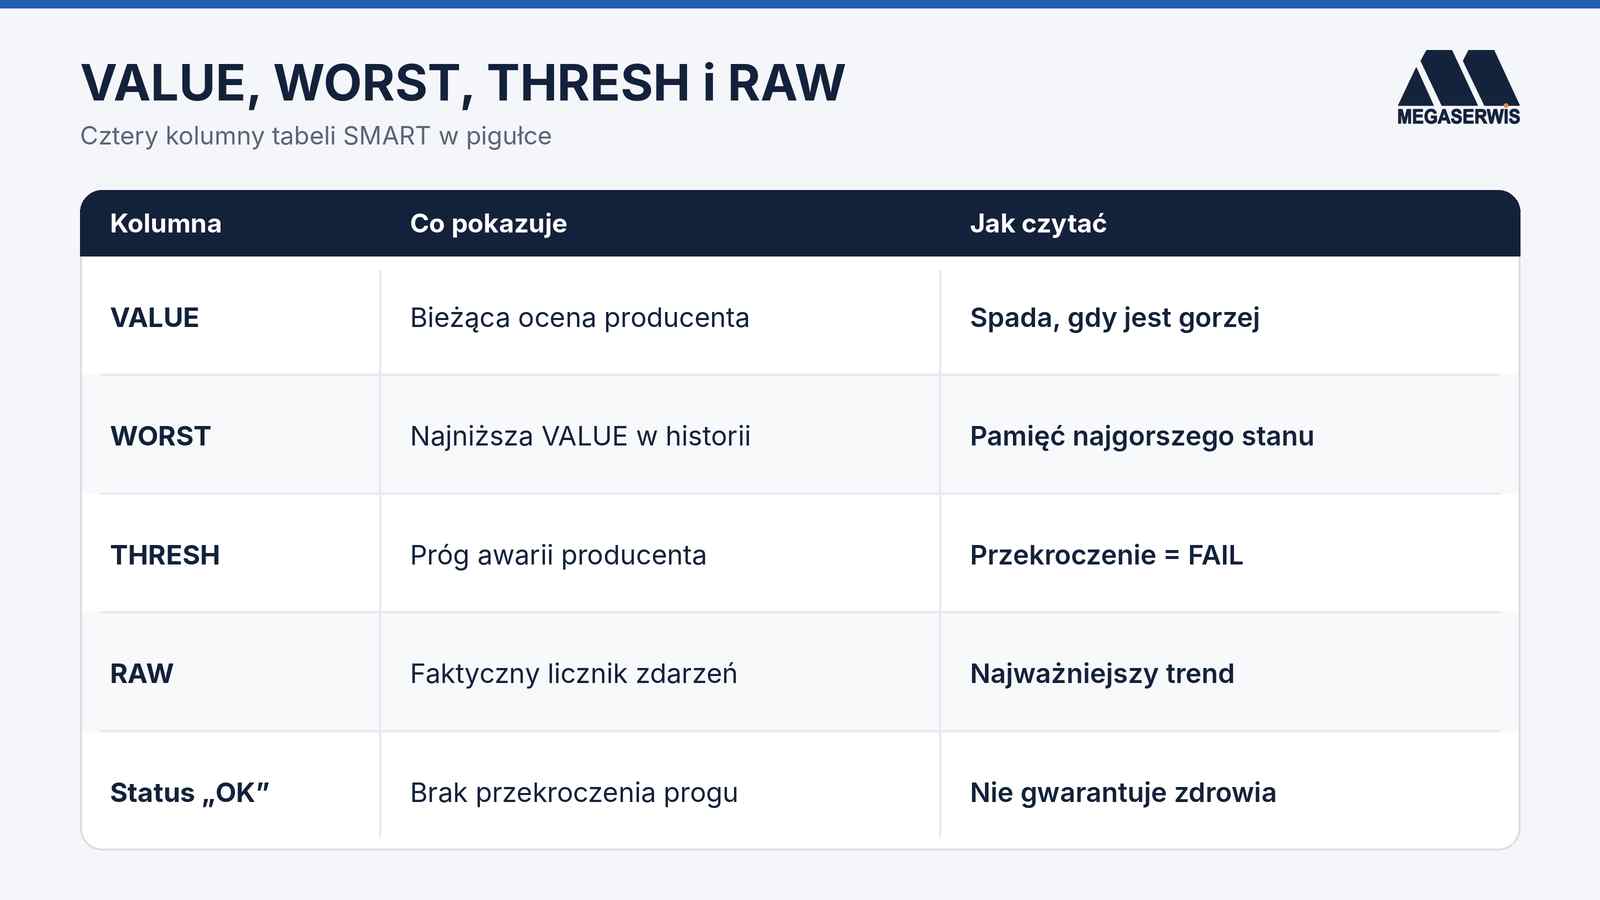
SMART (Self-Monitoring, Analysis and Reporting Technology) to system wbudowany w firmware dysku. Elektronika zlicza błędy odczytu, przemapowane sektory, temperaturę czy godziny pracy. Każdy atrybut ma numer (ID) oraz cztery kolumny:
- VALUE – bieżąca ocena wyliczona przez producenta,
- WORST – najniższa wartość VALUE, jaką atrybut kiedykolwiek osiągnął;
- THRESH – próg ustalony przez producenta; gdy VALUE spadnie do niego lub poniżej, atrybut uznaje się za przekroczony;
- RAW – surowa wartość, czyli faktyczny licznik lub pomiar, np. liczba sektorów albo godzin.
W praktyce najwięcej mówi kolumna RAW. Wartości znormalizowane nie są ujednolicone między producentami, a progi THRESH ustawiane są tak zachowawczo, że dysk bywa w złym stanie, zanim zostaną przekroczone.
Atrybuty, które naprawdę ostrzegają
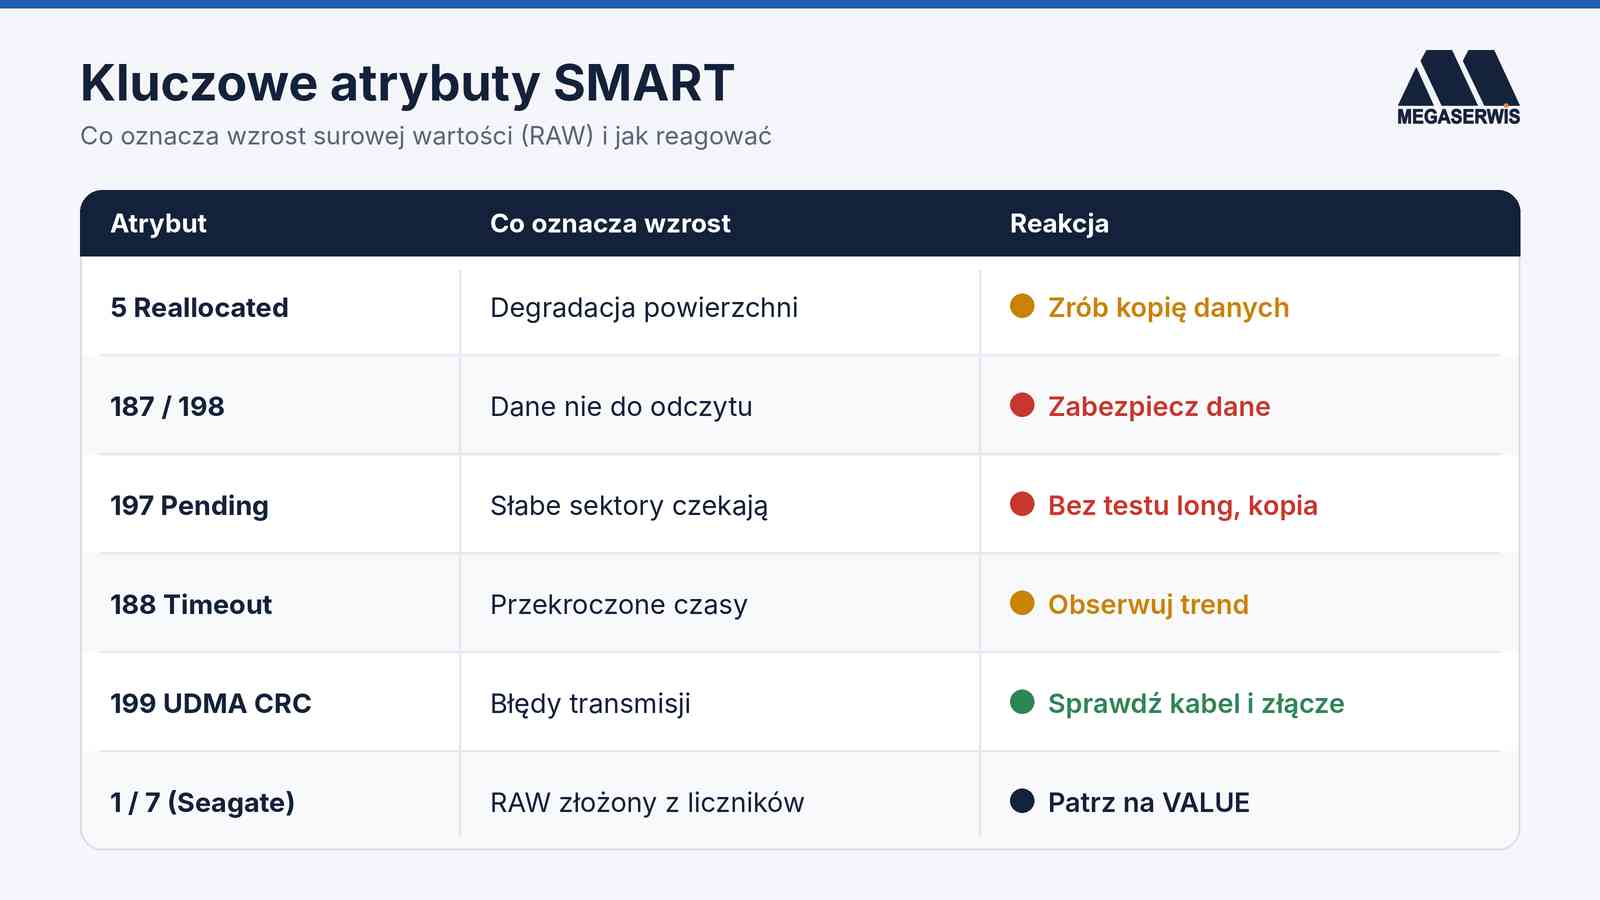
Przy dyskach HDD warto skupić się na kilku pozycjach. Ich wzrost oznacza problem z powierzchnią talerzy lub odczytem:
- 5 Reallocated Sectors Count – sektory przeniesione do rezerwy; rosnąca wartość oznacza postępującą degradację powierzchni;
- 187 Reported Uncorrectable Errors – błędy, których nie naprawiła korekcja ECC;
- 188 Command Timeout – polecenia, na które dysk nie odpowiedział na czas; pojedyncze przypadki bywają niegroźne, istotny jest trend;
- 197 Current Pending Sector Count – sektory, których dysk nie potrafi teraz odczytać i czekają na decyzję o przemapowaniu;
- 198 Offline Uncorrectable – sektory nieczytelne wykryte podczas skanowania w tle lub autotestu.
Właśnie te pięć atrybutów śledzi Backblaze. W jej analizie z 2016 roku 76,7% dysków, które uległy awarii, miało co najmniej jeden z nich powyżej zera, podczas gdy wśród sprawnych było to 4,2%. Według raportu za 2025 rok Backblaze monitorowało ponad 349 tysięcy dysków przy rocznej awaryjności 1,36%.
Atrybuty mylące i informacyjne
Atrybut 199 UDMA CRC Error Count prawie zawsze wskazuje na problem z transmisją: kabel SATA, złącze, kontroler lub zasilanie, a nie na talerze. Licznik nigdy się nie zeruje, więc liczy się tylko jego przyrost. Atrybut 9 Power-On Hours to po prostu licznik godzin pracy. Sam w sobie nie przewiduje awarii, ale daje kontekst: dysk z kilkudziesięcioma tysiącami godzin jest w późniejszej fazie życia. Atrybut 194 to temperatura; długotrwała praca powyżej około 50°C skraca żywotność. Osobna sprawa to dyski Seagate. Atrybuty 1 (Raw Read Error Rate) i 7 (Seek Error Rate) mają tam surową wartość złożoną z dwóch liczników zapisanych w jednej liczbie, dlatego programy pokazują wielomilionowe wartości. To nie są miliony błędów. Tu patrzymy na VALUE względem THRESH, nie na RAW. Źródła różnie opisują, która część liczby to błędy, a która liczba operacji.
Ograniczenia SMART i status „Dobry”
SMART wychwytuje powolną degradację, ale nie nagłe zdarzenia. W danych Backblaze 23,3% dysków padło bez ostrzeżenia w żadnym z pięciu kluczowych atrybutów. Upadek, przepięcie czy nagła awaria głowic mogą zabić dysk z idealną historią. Ogólny status „OK”, „PASSED” czy „Dobry” oznacza jedynie, że żaden atrybut nie przekroczył progu producenta. Ważniejsza od statusu jest zmiana surowych liczników w czasie. Procentowe oceny „zdrowia” w różnych programach są liczone według własnych kryteriów, więc dwa narzędzia mogą ocenić ten sam dysk inaczej.
Narzędzia i testy short/long
Do odczytu SMART w Windows najwygodniejszy jest CrystalDiskInfo (aktualnie wersja 9.9.3 z października 2026). Bardziej zaawansowani użytkownicy sięgną po smartctl z pakietu smartmontools (obecnie wersja 7.5). Polecenie smartctl -a pokazuje pełną tabelę. Dysk potrafi też sam się przetestować. Test krótki (short) trwa zwykle około 2 minut. Test długi (long, extended) czyta całą powierzchnię i na dużych dyskach trwa wiele godzin. I tu ważne ostrzeżenie: na dysku, który już ma sektory oczekujące, nieczytelne lub objawy fizyczne, test długi może zaszkodzić. Wymusza odczyt każdego sektora, a przy słabych miejscach dysk wielokrotnie ponawia próby. To obciąża głowice, które mogą być już osłabione, i może przyspieszyć przejście od pojedynczych błędów do uszkodzenia uniemożliwiającego zwykły odczyt. Najpierw zabezpiecza się dane, potem diagnozuje. Gdy dysk stuka lub znika z systemu, wyłącz go i nie skanuj. O pojedynczych bad sectorach i planie na pierwszą dobę piszemy osobno. Krótko o SSD: dyski półprzewodnikowe mają inny zestaw atrybutów, m.in. zużycie komórek i zapas bloków rezerwowych, a numeracja atrybutów SSD nie jest ujednolicona między producentami.
Podsumowanie
SMART to cenne źródło informacji, pod warunkiem że czytamy surowe wartości atrybutów 5, 187, 188, 197 i 198 oraz obserwujemy ich zmiany, a nie polegamy na zielonym statusie. Błędy CRC zwykle oznaczają kabel, a wielkie liczby w atrybutach 1 i 7 u Seagate nie są powodem do paniki. Jeśli liczniki rosną albo dysk zachowuje się niepokojąco, skontaktuj się z laboratorium odzyskiwania danych. Deklarujemy bezpłatną wstępną diagnozę i wycenę przed rozpoczęciem jakichkolwiek prac.